PDF escaneado no Chat: agora a IA lê o que antes era só imagem
Contrato digitalizado, laudo, nota antiga: o CollaborAI passou a reconhecer o texto de PDFs escaneados com OCR e a dizer com clareza quando um arquivo ainda está sendo lido, quando falhou e o que fazer.
Quase toda empresa tem uma pasta de PDFs que não são bem PDFs: são fotos de páginas. O contrato assinado e passado no scanner, o laudo que veio do fornecedor, a nota fiscal de 2019, o manual que alguém fotografou com o celular. Para quem abre, parece um documento. Por dentro, não há uma única letra, só a imagem de cada página.
Até a versão de 2 de outubro, mandar um arquivo desses no Chat terminava mal. A extração de texto não achava nada, e a resposta que voltava era vaga: algo como “a indexação pode ainda estar em andamento”. Você perguntava de novo, e a resposta se repetia, porque o arquivo nunca ia ficar pronto.
Isso mudou. O Chat agora reconhece o texto de PDFs escaneados e diz com clareza em que pé está a leitura de cada arquivo.
O que mudou
Três coisas, que juntas resolvem o problema:
- OCR para PDF sem texto. Quando o CollaborAI não encontra texto selecionável num PDF, o arquivo passa por reconhecimento óptico de caracteres (OCR) no Amazon Textract, o serviço da AWS para isso. O texto reconhecido vira a base das respostas, como se o documento tivesse sido digitado.
- A leitura começa no instante do envio. O arquivo entra na fila de processamento assim que você manda a mensagem, e o Chat espera alguns segundos pela leitura antes de responder. Se ela terminar nessa janela, a resposta já vem com o conteúdo do documento; se não, o Chat avisa que ainda está lendo.
- Status de verdade, em vez de mensagem genérica. O Chat agora sabe se o arquivo ainda está sendo processado, se ficou pronto ou se falhou, e conta isso a você com o motivo.
Como fica na prática
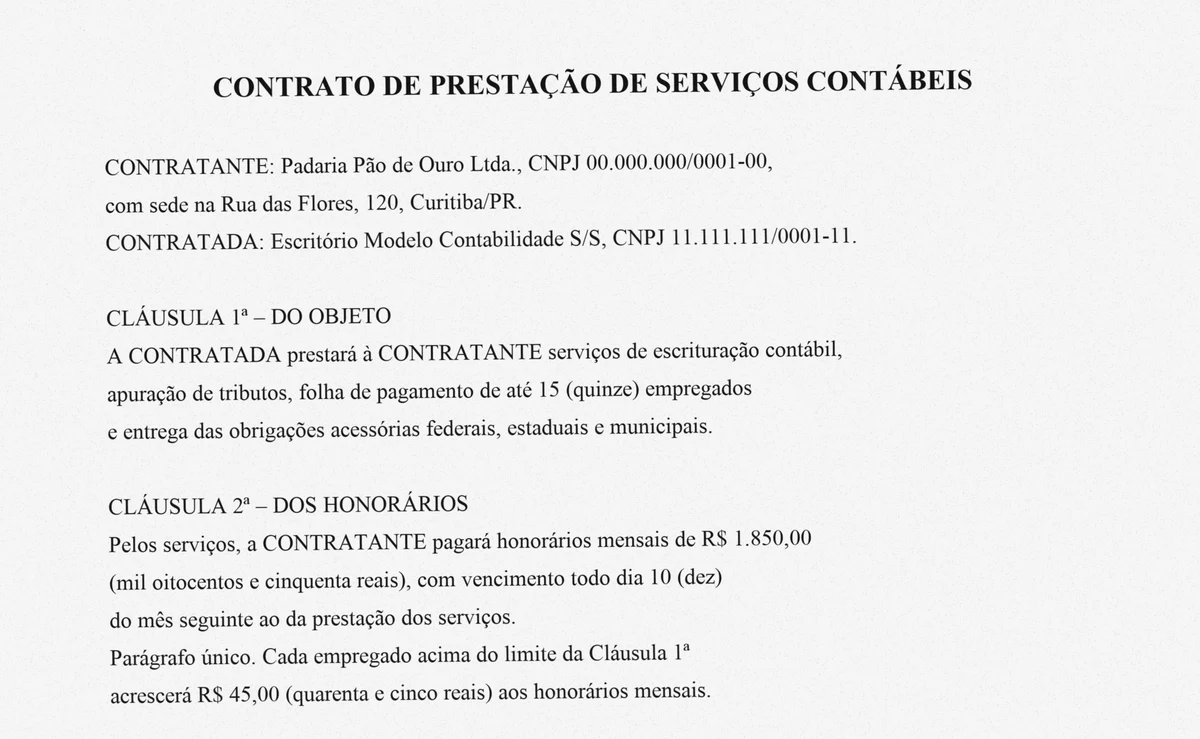
Para testar, usamos um contrato fictício de prestação de serviços contábeis, digitalizado em duas páginas, sem nenhuma camada de texto. Selecionar com o mouse não pega uma palavra sequer.
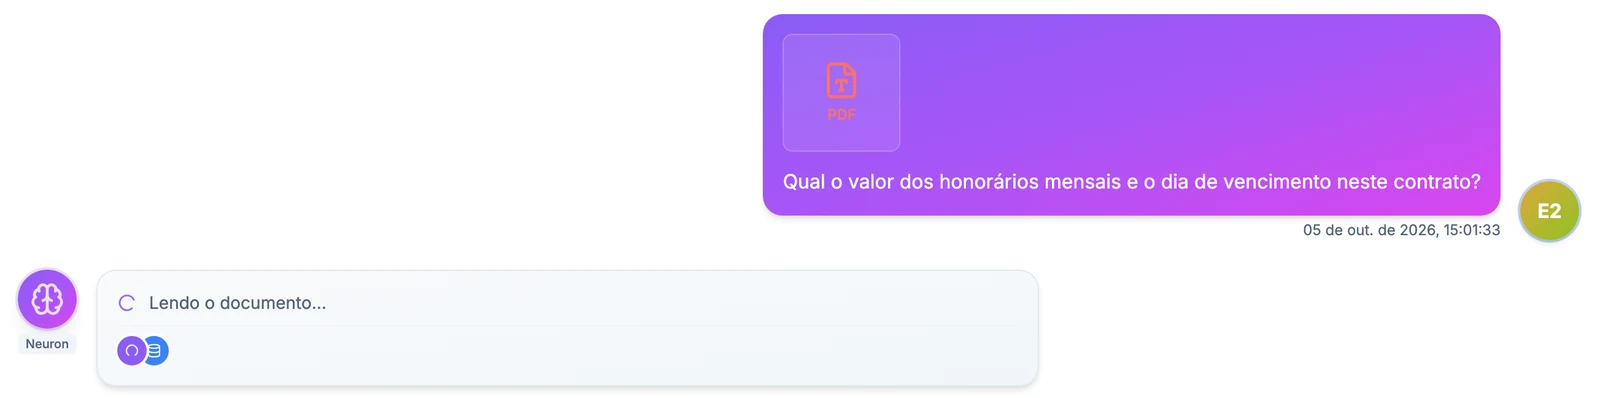
O arquivo foi anexado com uma pergunta direta: qual o valor dos honorários e o dia de vencimento. Enquanto o documento é lido, o Chat mostra o andamento.
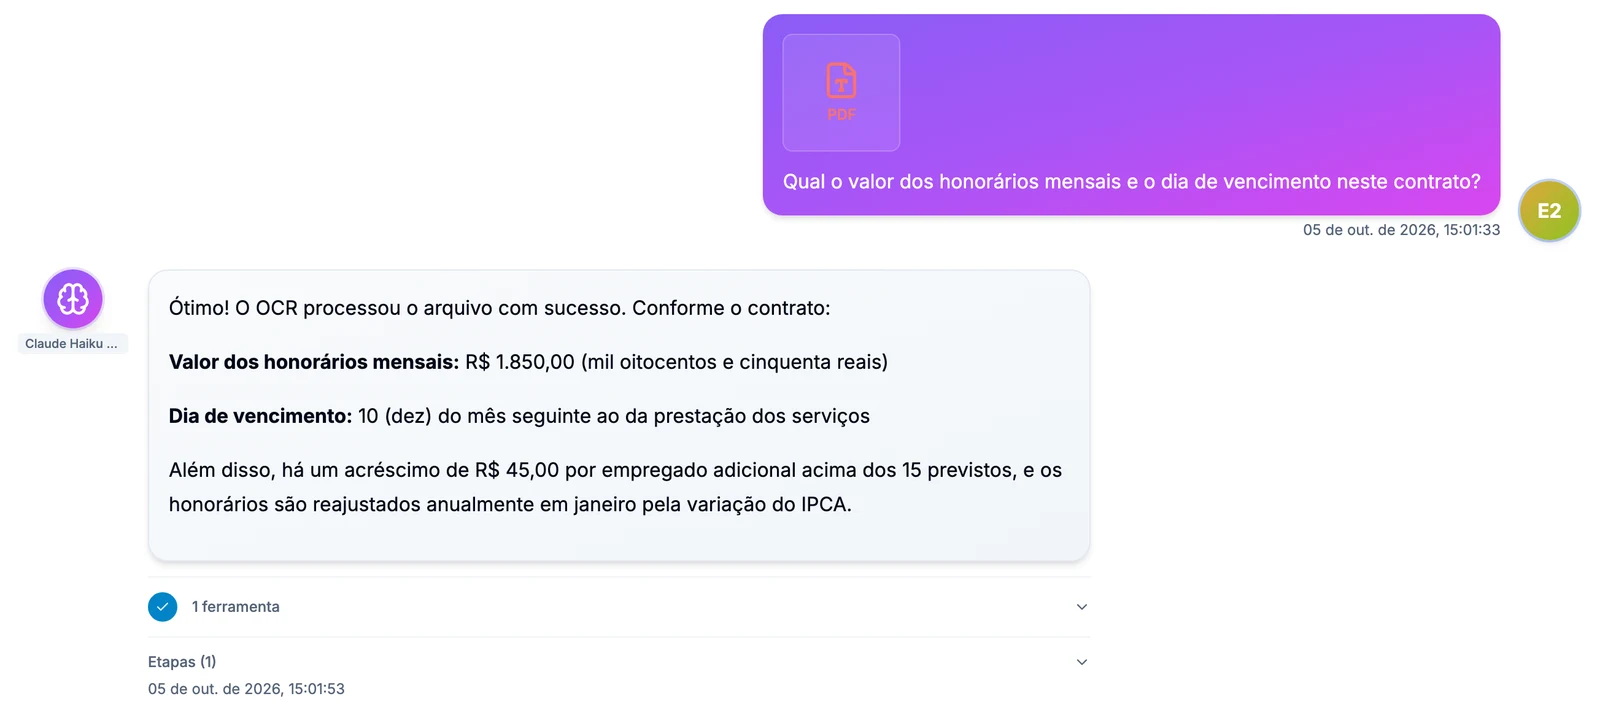
Em cerca de 20 segundos veio a resposta, com os valores certos e dois detalhes que não tinham sido pedidos, mas estavam no contrato: o acréscimo por empregado excedente e o índice de reajuste.
Depois de lido, o arquivo continua disponível na conversa. Você pode seguir perguntando sobre prazo de rescisão, multa ou foro sem anexar de novo.
Quando o OCR entra em ação
Você não precisa ligar nada. O CollaborAI decide sozinho pelo tipo de arquivo:
| O que você anexa | O que acontece |
|---|---|
| PDF com texto selecionável | O texto é lido direto do arquivo, sem OCR |
| PDF escaneado, só com imagens das páginas | Passa por OCR |
| Foto ou imagem (JPG, PNG) | Vai para o modelo como imagem, e os modelos com visão leem direto |
| Word, Excel ou PowerPoint | O texto é extraído do arquivo, sem OCR |
O OCR não consome créditos à parte. Você continua pagando apenas as mensagens, como sempre.
Quando não dá certo, o Chat diz por quê
A mudança menos visível é talvez a mais útil no dia a dia. Antes, um arquivo que nunca seria lido e um arquivo que só estava demorando produziam a mesma resposta. Agora são situações diferentes, com respostas diferentes:
- Ainda processando. Documentos longos podem levar mais do que a espera inicial. O Chat avisa que o OCR está em andamento e sugere perguntar de novo em instantes, sem afirmar que a informação não existe.
- Não há texto reconhecível. Se nem o OCR encontrar texto, por exemplo numa digitalização muito borrada, o Chat diz que é uma falha definitiva e sugere enviar uma versão com texto selecionável ou uma digitalização melhor. Não adianta insistir na mesma pergunta.
- O processamento foi interrompido. Se algo der errado no meio do caminho, o Chat deixa claro que o problema não é o conteúdo do arquivo e pede que você o reenvie.
- Pronto, mas a busca não achou. Se o arquivo foi lido e a resposta não apareceu, a IA é orientada a reformular a busca, com sinônimos ou trechos mais curtos, antes de concluir que a informação não está no documento.
Limites que valem saber
- Até 100 páginas por arquivo no OCR. Num PDF escaneado mais longo, o reconhecimento cobre as 100 primeiras páginas. Se o trecho que importa está no fim de um volume grande, separe as páginas antes de enviar.
- Arquivos de até 50 MB no Chat.
- A qualidade do scan manda no resultado. OCR lê bem página reta, com contraste e boa resolução. Foto torta, com sombra ou tremida, perde palavras, e número errado num contrato é pior que número nenhum.
Para digitalizar pensando na IA:
- Use a função de digitalizar documento do celular ou do scanner, não a câmera comum. Ela corrige perspectiva e contraste sozinha.
- Prefira 300 dpi quando o scanner permitir escolher.
- Uma página por imagem, inteira no quadro, sem dedo na borda.
- Se o documento original existe em formato digital, envie esse. Texto nativo é sempre mais confiável que texto reconhecido.
O que fazer com isso
Vale revisitar o que ficou para trás. Aquele contrato antigo que a IA “não conseguia abrir”, o manual escaneado do equipamento, o lote de laudos em PDF: tudo isso agora entra na conversa como qualquer outro documento.
E, como em qualquer leitura feita por máquina, confira o que for decisivo. Para cláusula de contrato e número de nota fiscal, vale abrir o PDF e bater o olho antes de usar o valor.