Qual IA usar para cada tarefa: um guia prático de escolha de modelo
Com mais de 40 modelos disponíveis, escolher vira paralisia. Um mapa direto de qual usar para escrever, analisar, ler documento gigante, gerar imagem e gerar vídeo.
Ter acesso a mais de 40 modelos de IA resolve um problema e cria outro. Você deixa de ficar preso à limitação de um modelo só — e passa a olhar para uma lista comprida sem saber qual clicar.
Este guia é o mapa. Ele existe para você parar de pensar nisso.
Primeiro: talvez você não precise escolher
O padrão do Chat é o Neuron, primeira opção do seletor de modelos. Ele é um orquestrador: coordena os modelos por baixo em uma identidade única e, no modo automático, roda sobre o Claude Haiku 4.5.
Para a maior parte do trabalho, o Neuron é a resposta certa. Você escreve, ele resolve, e você não gasta atenção decidindo.
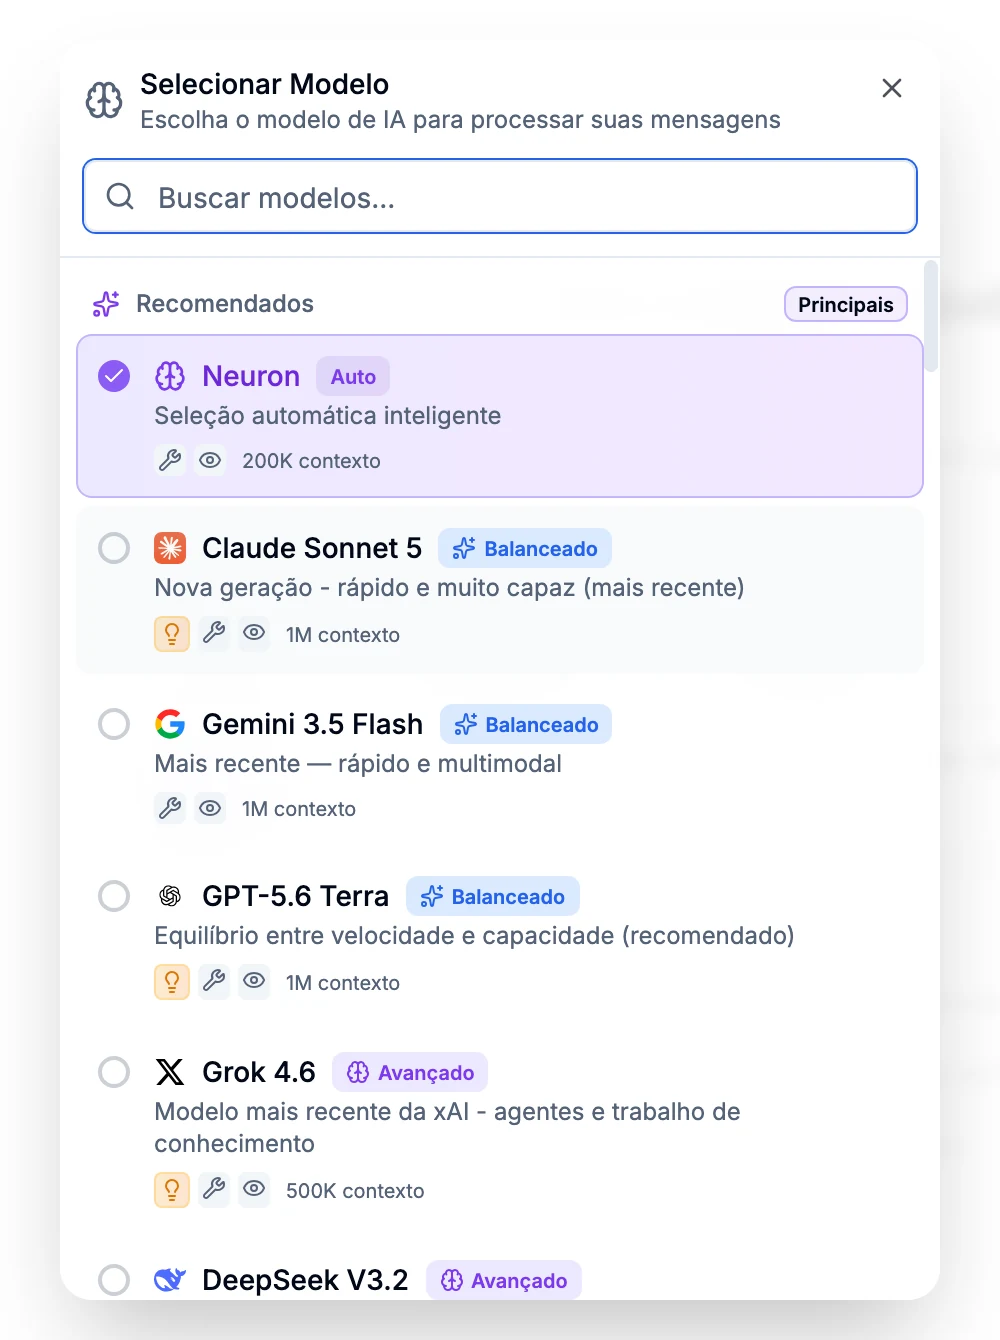
O resto deste artigo é para quando você quer mandar — porque a tarefa é específica, o orçamento importa ou o documento é grande demais.
Modelos de texto
A regra prática cabe em quatro linhas:
| Situação | Modelo | Por quê |
|---|---|---|
| Volume alto, respostas rápidas, atendimento | Claude Haiku 4.5 | Rápido e barato. É o motor do Neuron no automático. |
| Trabalho do dia a dia: escrever, revisar, resumir | Claude Sonnet 5 | O equilíbrio entre qualidade e velocidade. |
| Análise profunda, raciocínio pesado, decisão difícil | GPT-5.6 Sol, Grok 4.6 ou, no Enterprise, Claude Opus 5 | Mais lentos e mais caros, e valem quando o problema é duro. |
| Documento muito longo | Sonnet 5, qualquer GPT-5.6, Gemini 3.1 Pro ou Llama 4 Maverick | Contexto de 1 milhão de tokens. |
A plataforma reúne modelos de 14 provedores — além dos acima, há Grok 4.6, Nova, Mistral Large 3, DeepSeek V3.2 e R1, Qwen 3, Kimi K2.5, GLM 5 e Nemotron, entre outros. Vale experimentar, mas se você seguir só a tabela acima já resolve quase tudo.
O erro mais caro: usar o modelo pesado para tudo
É tentador deixar sempre no melhor modelo. Só que num plano Pro as mensagens com modelos rápidos e avançados são ilimitadas, enquanto os modelos Opus têm cota de 100 mensagens por mês.
Gastar Opus em “resuma este e-mail” é queimar a cota que você vai querer na análise de contrato da semana que vem. Deixe o padrão no Neuron e suba de modelo quando a tarefa pedir.
O ajuste que vale conhecer: nível de raciocínio
Ao escolher um GPT-5.6 ou o Grok 4.6 no seletor, o Chat pergunta quanto você quer que o modelo pense antes de responder.
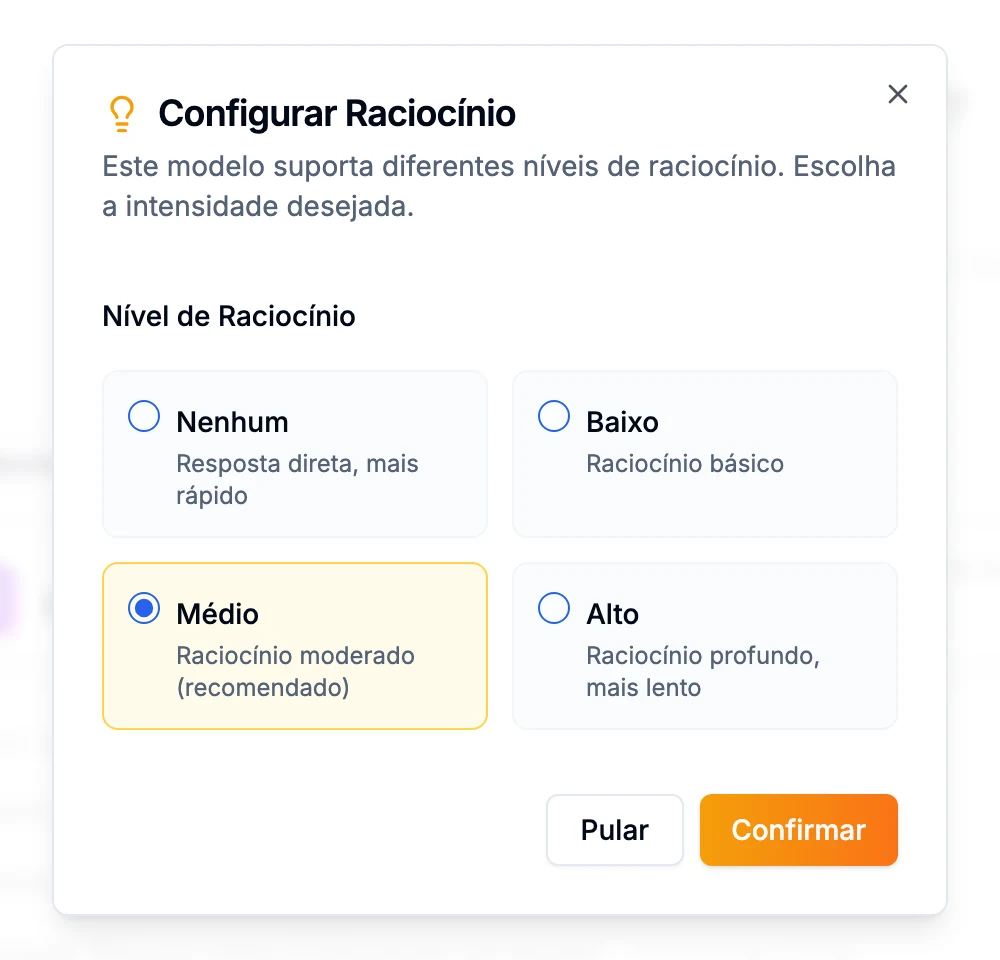
A leitura prática:
- Nenhum ou baixo quando você quer velocidade: resposta direta, classificação, extração.
- Médio para o trabalho normal. É o recomendado e resolve quase tudo.
- Alto para problemas que exigem várias etapas de pensamento, aceitando esperar mais.
Subir o nível não melhora uma pergunta mal feita. Ele ajuda quando o problema é genuinamente difícil, não quando falta contexto no pedido.
Modelos de imagem
Aqui a escolha é de orçamento, porque imagem consome créditos. O custo aparece no próprio seletor, ao lado do nome de cada modelo:
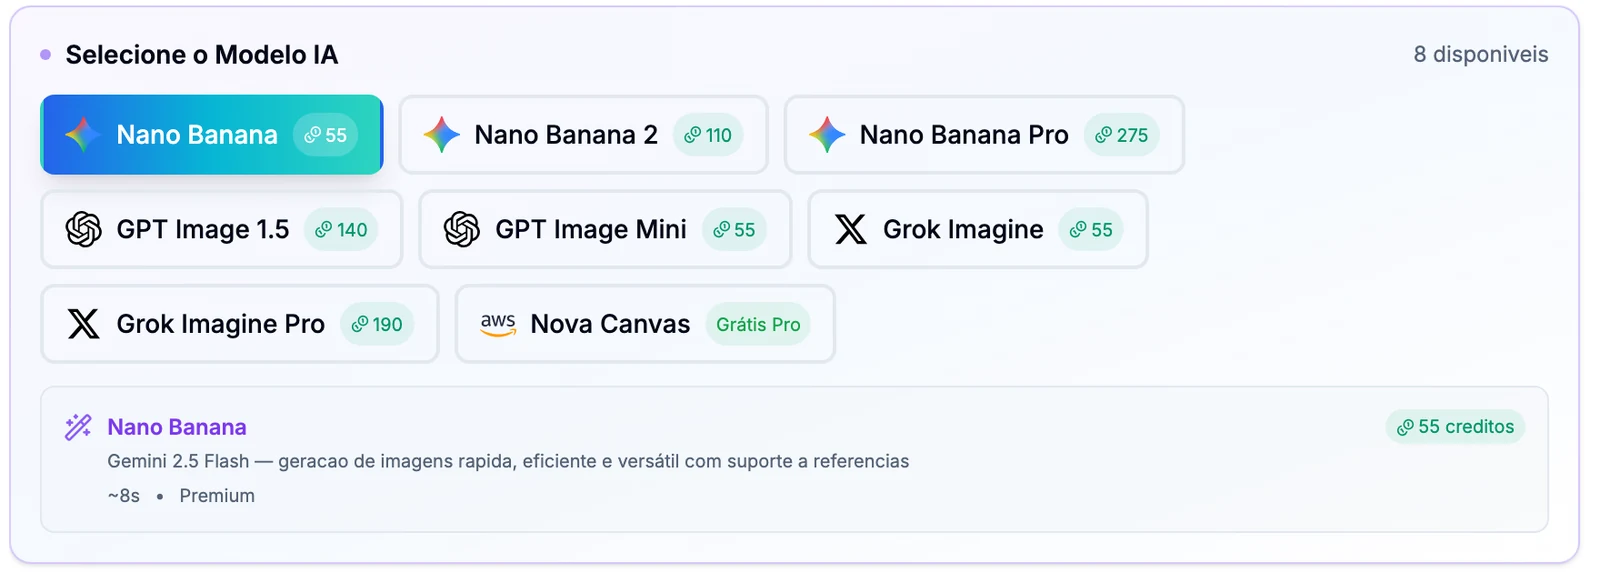
Os valores por imagem:
| Modelo | Créditos |
|---|---|
| Nova Canvas | grátis para assinantes Pro |
| Nano Banana (Flash), GPT Image Mini, Grok Imagine | 55 |
| Nano Banana 2 | 110 |
| GPT Image 1.5 | 140 |
| Grok Imagine Pro | 190 |
| Nano Banana Pro | 275 (490 em 4K) |
Comece sempre pelo Nova Canvas. Ele é gratuito no Pro, então é onde você testa o prompt, ajusta a composição e erra à vontade. Só migre para um modelo pago quando a ideia já estiver certa e você quiser o acabamento.
Outra economia que quase ninguém faz: use imagens de referência para guiar estilo, composição ou assunto. Chegar no resultado com duas gerações em vez de dez é a maior economia disponível.
Modelos de vídeo
Vídeo é o item mais caro da plataforma, e o custo é por segundo:
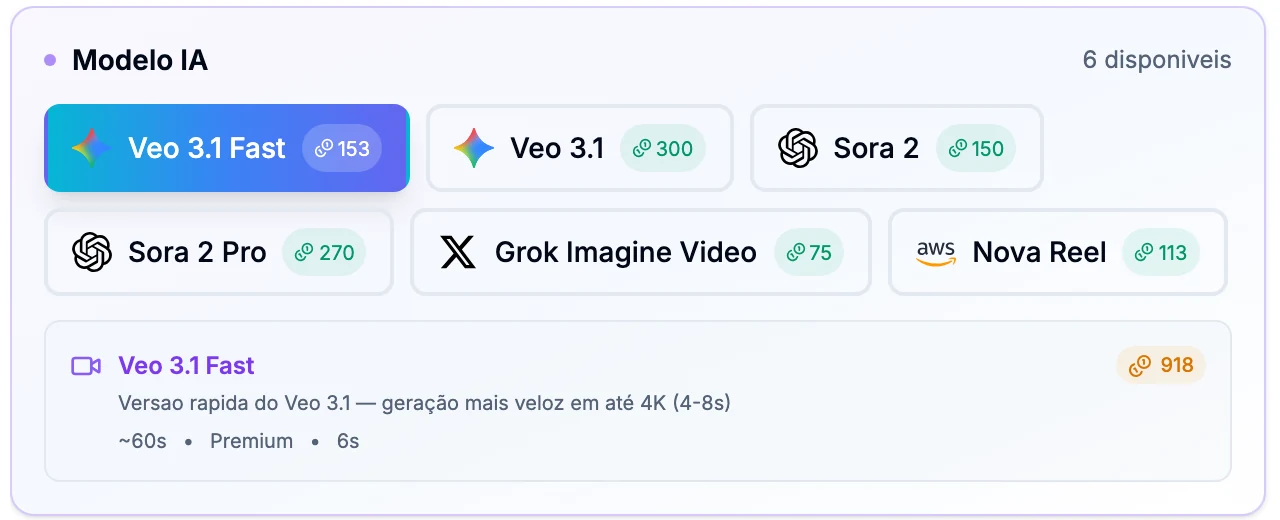
| Modelo | Créditos por segundo |
|---|---|
| Grok Imagine Video | 75 |
| Nova Reel | 113 |
| Sora 2 | 150 |
| Veo 3.1 Fast | 153 |
| Sora 2 Pro | 270 |
| Veo 3.1 | 300 |
A leitura prática:
- Testando uma ideia? Grok Imagine Video, o mais barato por segundo.
- Precisa de vídeo longo? Nova Reel, que vai até 120 segundos.
- Peça final, qualidade máxima? Veo 3.1.
Um vídeo de 10 segundos no Veo 3.1 custa 3.000 créditos — quase um terço dos 10.000 créditos mensais do Pro. Vale roteirizar antes de gerar.
Um fluxo que funciona
Para quem não quer decorar tabela, este roteiro cobre a maior parte dos casos:
- Comece no Neuron. Deixe o padrão e escreva.
- Se a resposta estiver rasa, troque para Sonnet 5 e repita a pergunta na mesma conversa — o contexto é mantido.
- Se ainda estiver rasa e o problema for realmente difícil, suba para GPT-5.6 Sol, Grok 4.6 ou, se a sua conta for Enterprise, Claude Opus 5.
- Se o material for enorme, escolha um modelo de 1 milhão de tokens de contexto — ou, melhor, coloque o material em uma Base de Conhecimento e deixe a busca fazer o trabalho.
- Para imagem, prototipe no Nova Canvas e finalize no modelo pago.
- Para vídeo, roteirize antes, teste curto e barato, e só então gere a versão final.
O ponto que importa: você não precisa acertar de primeira. Trocar de modelo no meio de uma conversa é um clique e não perde o contexto. Na dúvida, deixe no Neuron e siga trabalhando.